«OpenAI обучила модель на пороге AGI». Проследили слух до первоисточника
 Автор: Редакция FactCheckers
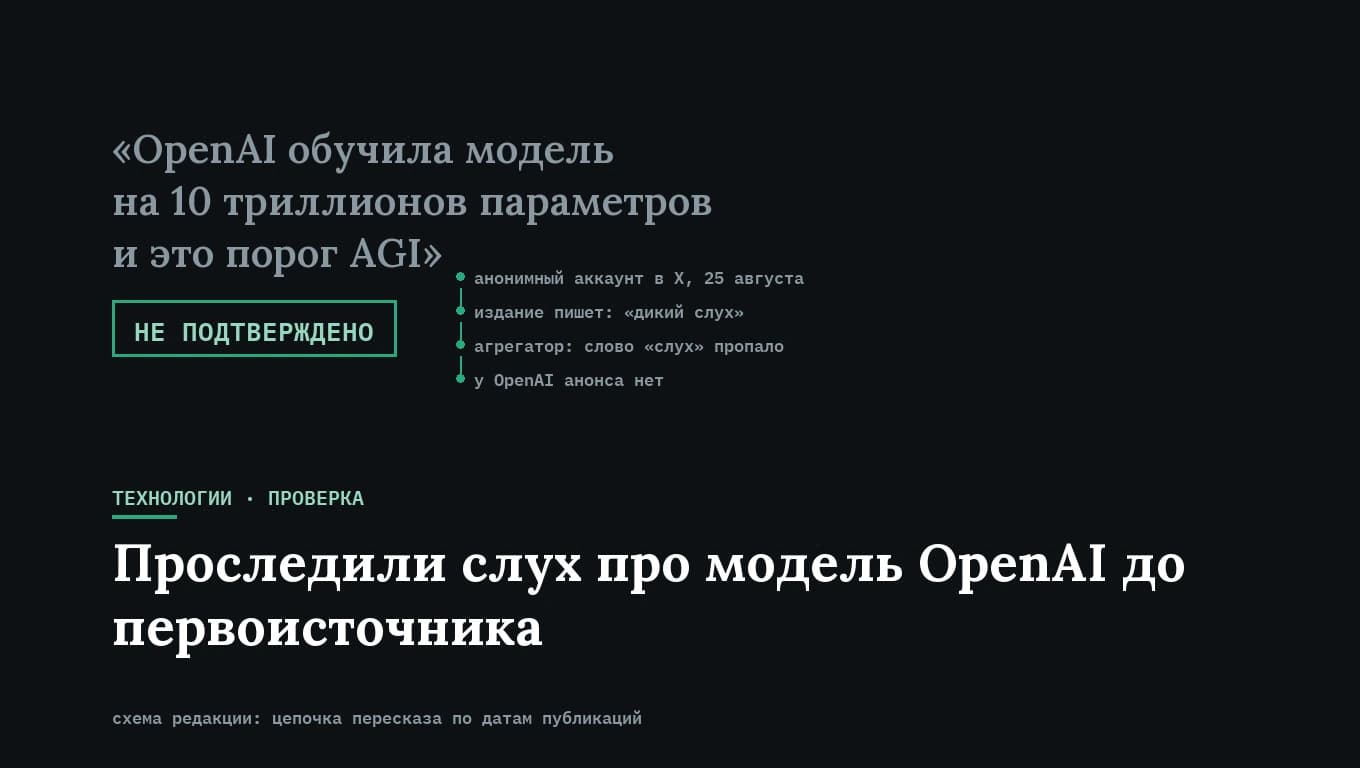
Коротко: по сети расходится новость, что OpenAI закончила обучение модели с кодовым именем Bel на 10 триллионов параметров и что это «первая базовая модель на пороге AGI». Мы проследили цепочку до начала. Источник один — анонимный аккаунт в соцсети X от 25 августа. Ни заявления OpenAI, ни документа, ни страницы продукта нет. Издание, которое первым это опубликовало, само называет сообщение слухом; к моменту, когда новость доходит до русскоязычных каналов, оговорка теряется. Вердикт: не подтверждено.
Что именно утверждается
Утверждение состоит из трёх частей, и их полезно разделить:
- OpenAI завершила предобучение новой модели под кодовым именем Bel.
- В ней больше 10 триллионов параметров.
- Она может стать «первой базовой моделью на пороге AGI» — то есть на пороге универсального искусственного интеллекта.
Первые две части — это утверждение о факте: либо обучение закончено, либо нет. Третья — оценка, причём с двумя смягчениями подряд: «может стать» и «на пороге». Такая формулировка не может быть ни подтверждена, ни опровергнута, потому что не утверждает ничего проверяемого.
Откуда это взялось: цепочка
Мы прошли её в обратную сторону.
| Звено | Как звучит здесь |
|---|---|
| Аккаунт в соцсети X, 25 августа | Помечено автором как «SCOOP» — эксклюзив. Ссылок на документы нет |
| Издание Wccftech | «Дикий слух, который сейчас ходит по соцсетям», «предположительно завершила», «согласно этому конкретному слуху» |
| Китайский агрегатор, 31 августа | «OpenAI завершила предобучение модели Bel на 10 триллионов параметров, возможно, станет первой базой AGI» |
Обратите внимание, что происходит по дороге. На первом звене это анонимное сообщение. На втором издание честно ставит слово «слух» — четыре раза. На третьем слово «слух» из заголовка уже исчезло, осталось только «возможно». Следующий шаг предсказуем: в пересказе пропадёт и «возможно».
Что говорит первоисточник
Первоисточник в такой новости один — сама OpenAI. Мы посмотрели её раздел новостей на 31 августа 2026 года. За неделю с 25 по 31 августа там опубликованы сообщения о расширении доступа к сервисам, о решении по Cursor после его покупки SpaceX, о поддержке стартапов в Таиланде, о работе с бразильским рынком, о ChatGPT для учителей и об инциденте с Hugging Face.
Ни модели Bel, ни модели на 10 триллионов параметров, ни GPT-6 в этих сообщениях нет. Самая новая названная модель — GPT-5.6.
Честно скажем, чего мы не знаем. Отсутствие анонса не доказывает, что обучения не было. Предобучение модели — внутренний этап работы, и компании обычно не сообщают о нём отдельно: объявляют готовый продукт. То есть слух может оказаться правдой. Но пока единственное его основание — анонимный аккаунт, а из этого не следует ничего.
Почему «10 триллионов параметров» — не то, что вы подумали
Параметры — это внутренние настроечные величины модели, которые подбираются при обучении. Их число говорит о размере, но не о способностях: модель большего размера не обязательно умнее, и наоборот. За последние два года направление развития скорее обратное — заметный прирост качества дают методы обучения и дообучения, а не наращивание размера.
Показательно, что сам слух этого и не отрицает: в исходном сообщении сказано, что Bel «примерно того же размерного класса, что GPT-4.5». То есть даже по версии самого слуха речь не о скачке в размере.
И отдельно про AGI. Универсального определения, при каком условии система считается универсальным искусственным интеллектом, не существует — нет ни признанного теста, ни порога. Поэтому фраза «на пороге AGI» не означает ничего измеримого, и проверить её нельзя в принципе.
Вердикт
Не подтверждено. Это не то же самое, что «ложь». Мы не нашли ни одного основания считать сообщение верным — только анонимный источник, — но и опровергнуть его нечем: компания о внутренних этапах работы не отчитывается. Правильное отношение к такой новости — отложить до подтверждения, а не пересказывать.
Как проверять такие новости самому
Три вопроса, которые занимают пять минут и снимают большинство подобных сообщений.
- Кто первый сказал? Не «кто написал у меня в ленте», а откуда взялось. Если цепочка упирается в аккаунт без имени — это и есть весь источник, сколько бы изданий его потом ни пересказали.
- Что говорит сама компания? У любой крупной технологической компании есть раздел новостей. Проверка занимает минуту: открыть и поискать. Молчание компании о собственном прорыве — сильный сигнал.
- Целы ли оговорки? Сравните заголовок с тем, что написано в теле исходной публикации. Если в оригинале стоит «предположительно», а в пересказе его нет — пересказ утверждает больше, чем знает автор оригинала.
Мы разбирали похожие сюжеты и раньше: какие слухи об ИИ оказались правдой, а какие нет. А про то, что реально доступно сегодня и чем модели отличаются друг от друга, — в разборе актуальных нейросетей.
Почему это важно не только любителям технологий
Новости про «прорыв к AGI» редко остаются новостями. Они быстро превращаются в аргумент: в рекламе курсов, в предложениях вложиться в «ИИ-стартап на раннем этапе», в разговорах о том, что через полгода не станет вашей профессии. Человек, принимающий решение о деньгах или о работе под впечатлением от сообщения анонимного аккаунта, принимает его на пустом месте.
Поэтому мы и разбираем такие сюжеты до того, как они дойдут до стадии «все говорят».
Редакция FactCheckers
Редакция FactCheckersПостоянный псевдоним редакции: за подписью стоит редакционный процесс, а не отдельный автор. Материалы готовим по открытым источникам и официальным документам, каждую цифру сверяем с первоисточником и приводим ссылки. Ответственность за публикацию несёт редакция. Как мы работаем